
龙明
Agent评估与CI验证34篇
2026-08-31 04:27:46
没有评测的 agent 迭代全靠感觉。这组 33 篇讲 evals 怎么落地:基准选择、LLM-as-judge 的坑、回归测试怎么进 CI、线上 shadow 评估,以及 SWE-bench 等基准的批判性分析。既有方法论,也有可以直接抄的流水线配置和真实团队的落地故事。想让 agent 质量可量化、每次改动有据可依的团队,从这组开始。
Demystifying Evals for AI Agen
Anthropic评估
promptfoo/promptfoo
GitHub提示
THUDM/AgentBench
清华Agent基准
Testing Agent Skills Systemati
OpenAI技能
Agent Evaluation Readiness Che
LangChain评估
Evaluating Skills
LangChain技能
AgentAssay: Token-Efficient Re
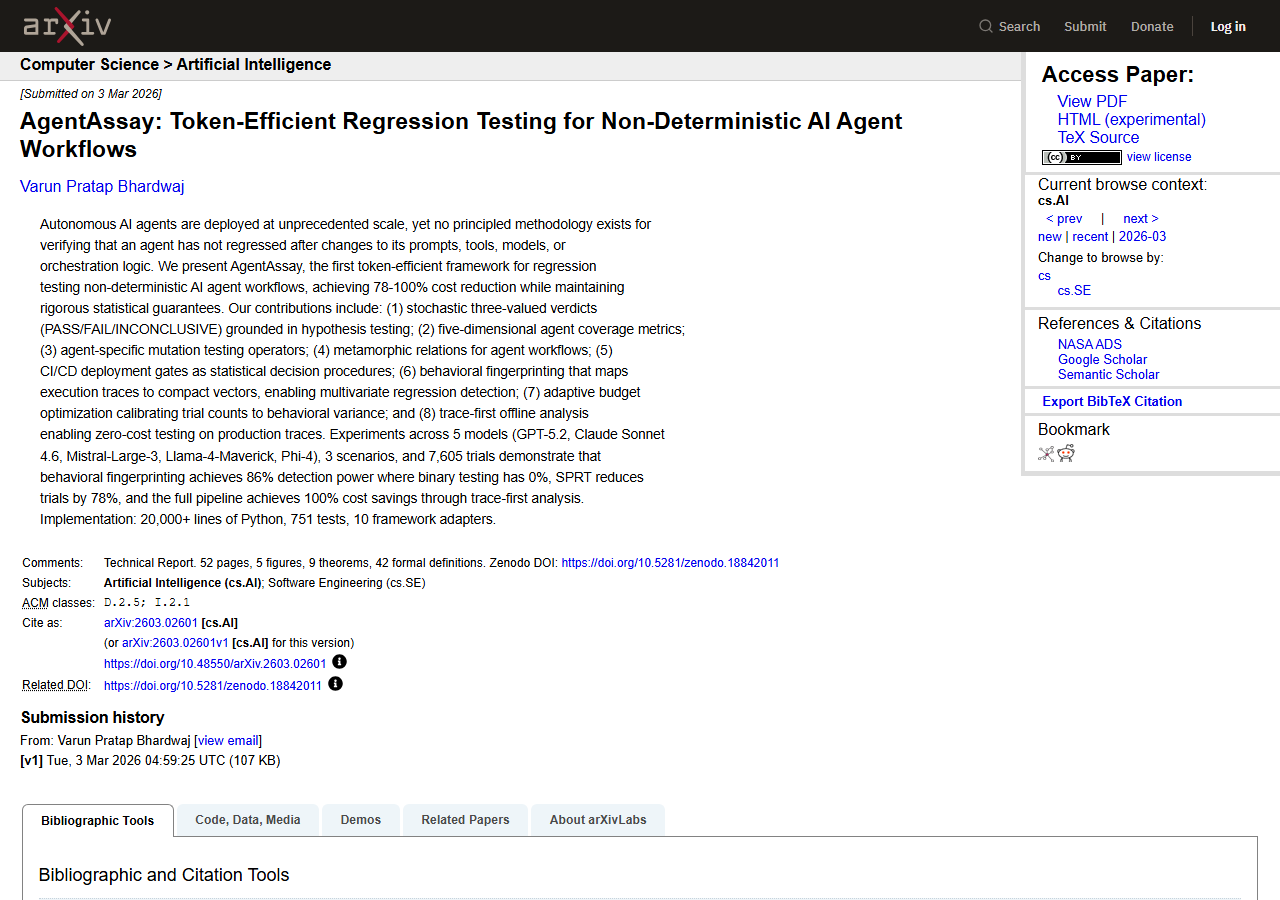
arXiv论文回归
Agentic Harness for Real-World
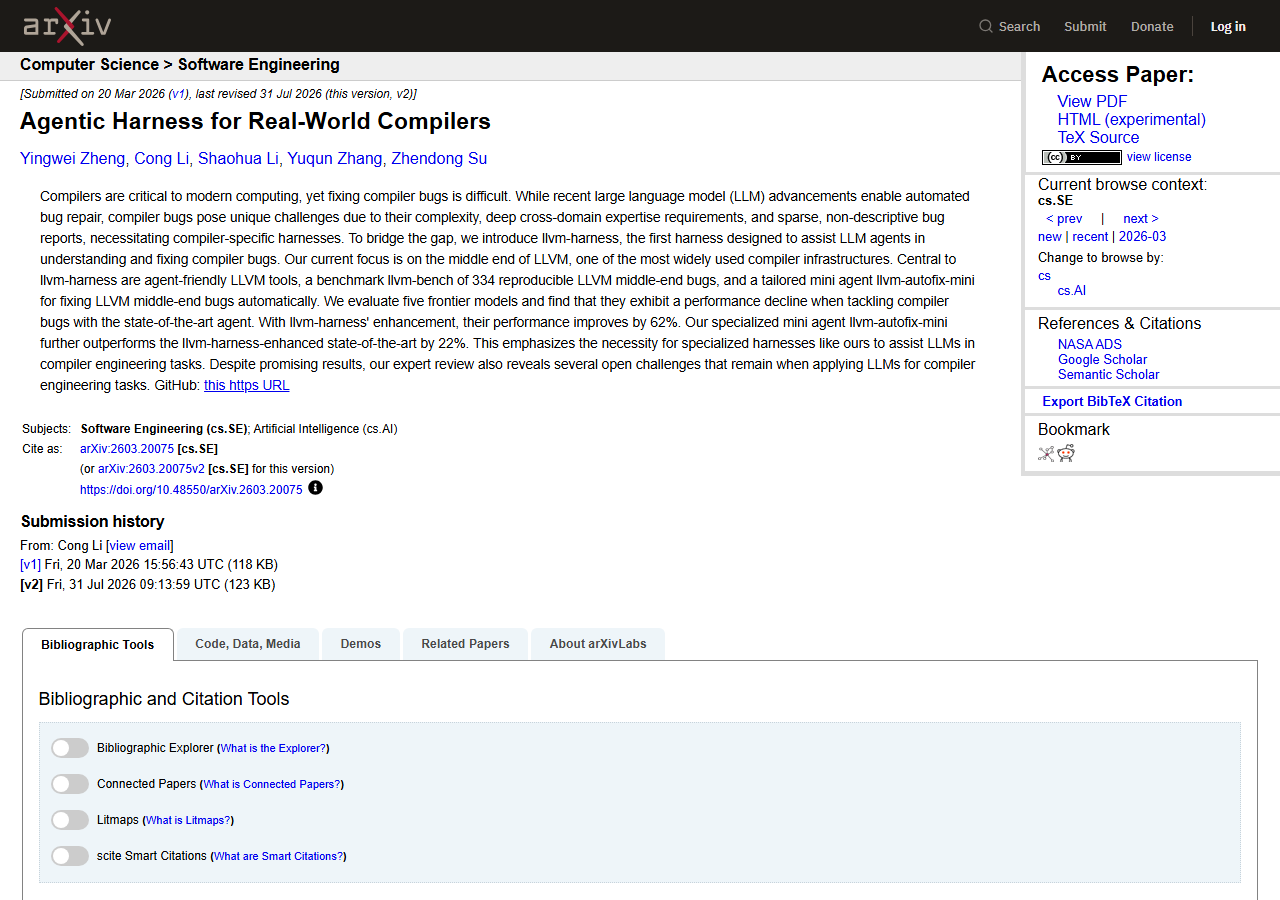
arXiv论文评估
Eval-Driven Development: Build
RedHat评估
Agent Evaluation Framework 202
Galileo评估
The 2025 AI Agent Index: Docum
arXiv论文Agent索引
sentrux/sentrux
GitHub评估
Driving the Agent Quality Flyw
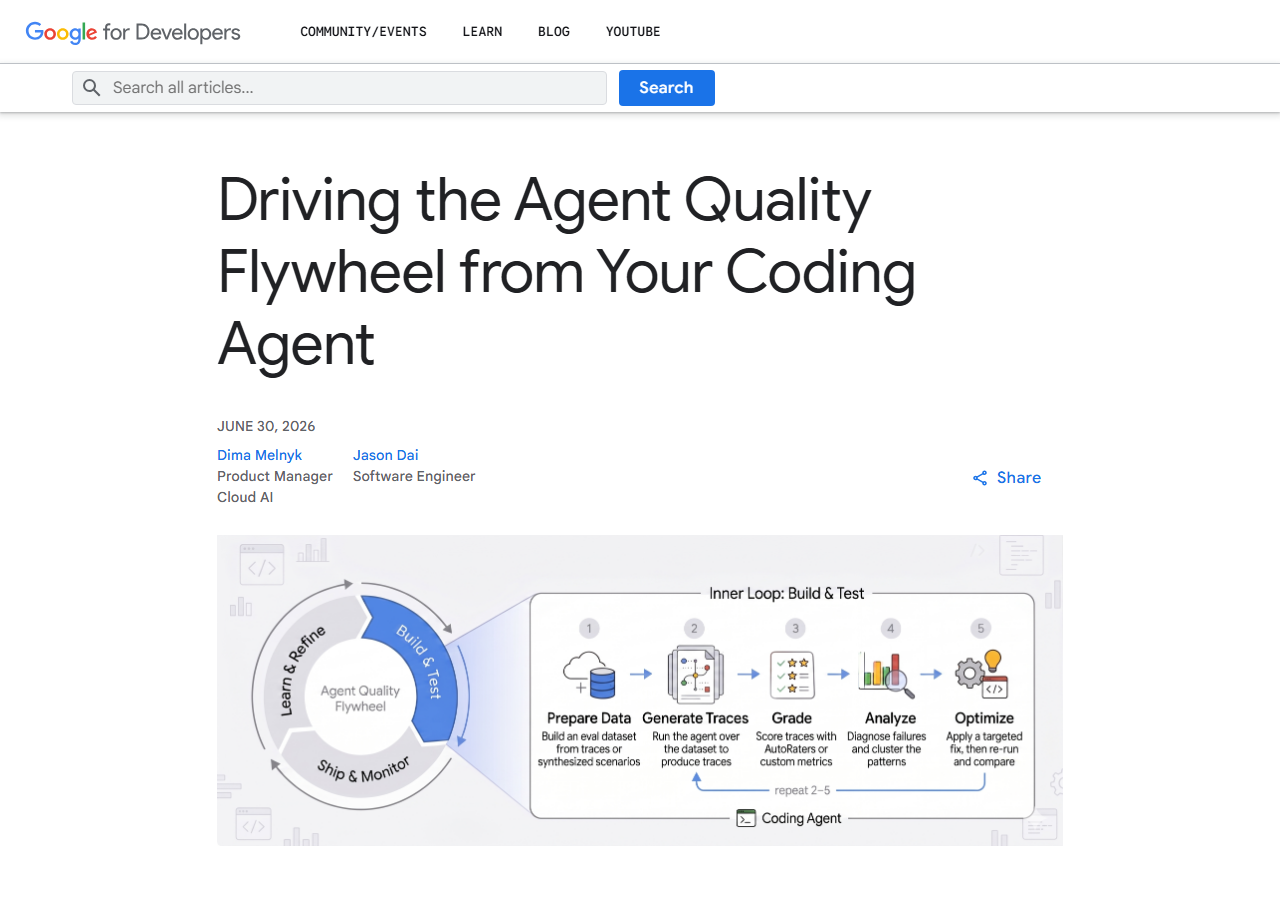
Google质量
vaquarkhan/mcp-test-harness
GitHubMCP
confident-ai/deepeval
GitHub评估
claw-eval/claw-eval
GitHub评估
SWE-bench
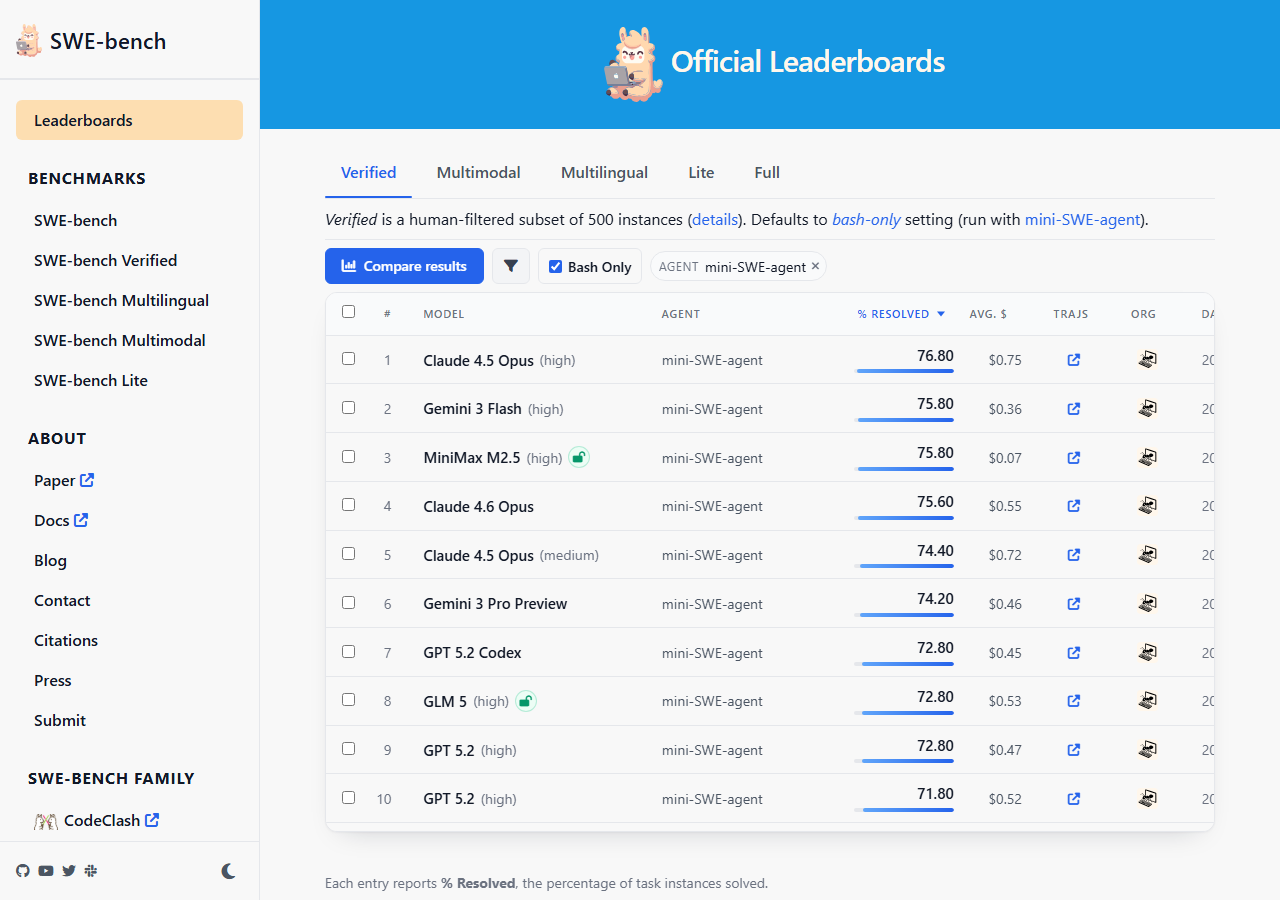
SWE-bench编程
Accio-org/RealReplicaBench
GitHub复现
UKGovernmentBEIS/inspect_ai
GitHub评估
Quantifying Infrastructure Noi
Anthropic基础
AgentLens: Revealing The Lucky
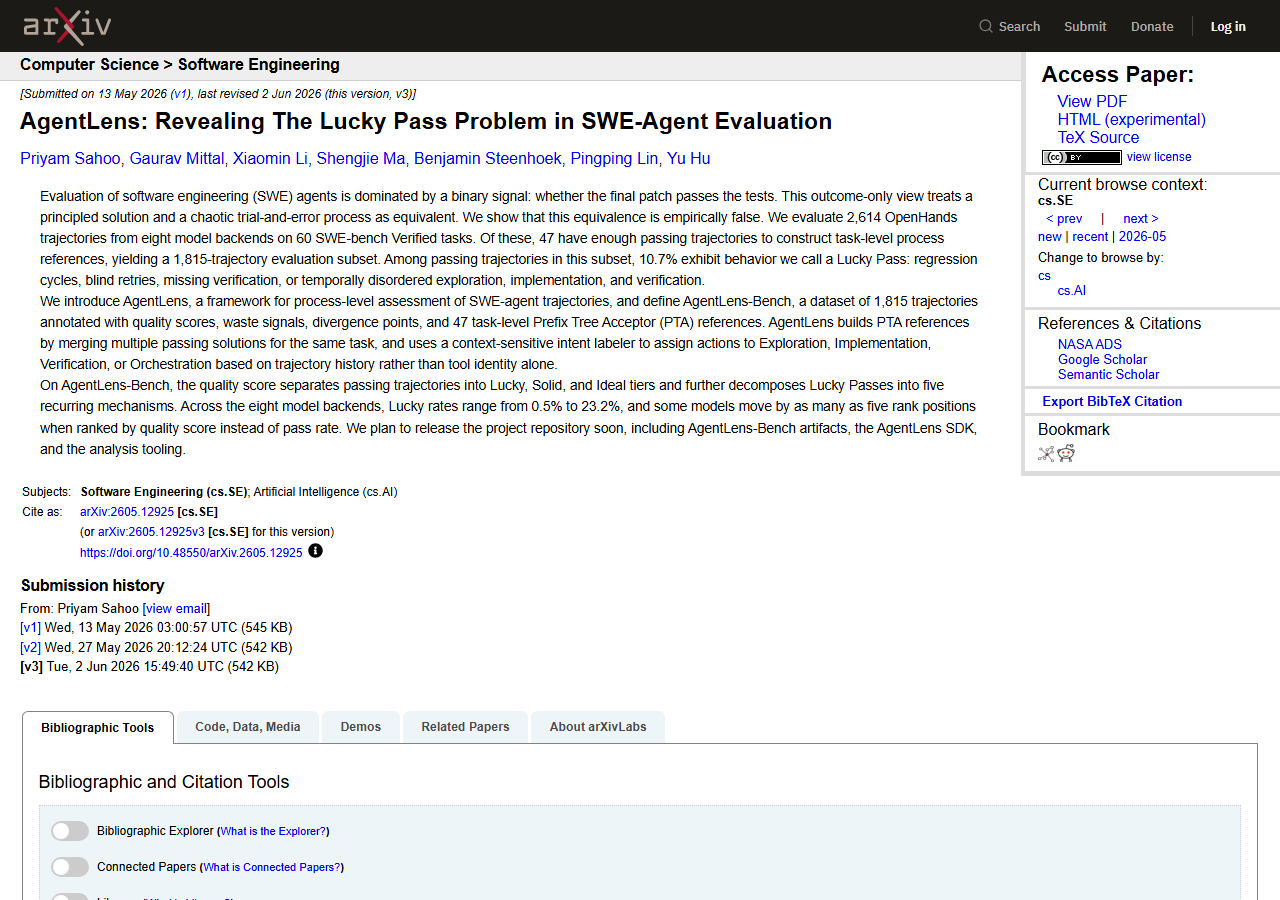
arXiv论文运气
StaminaBench: Stress-Testing C
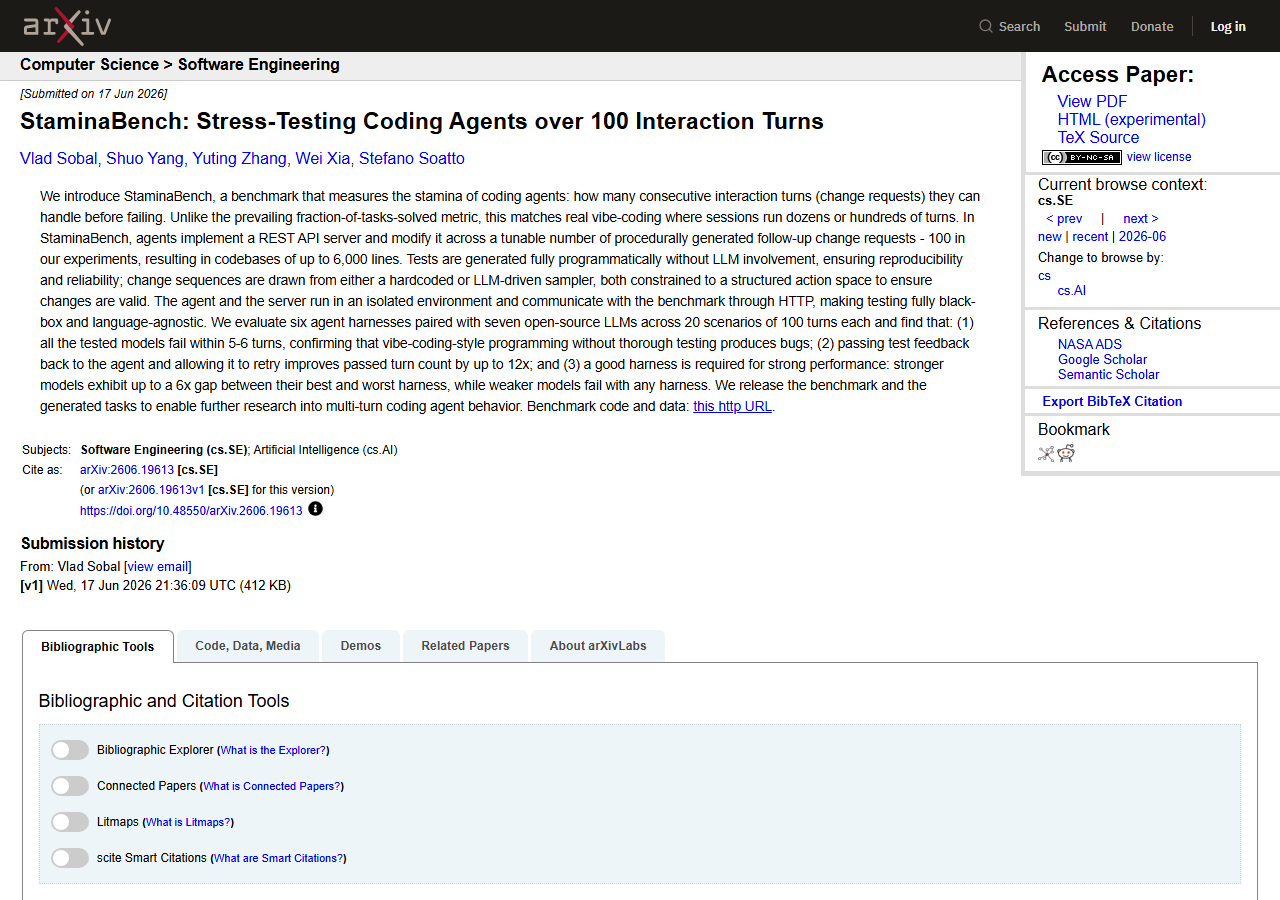
arXiv论文压力
Harness-Bench: Measuring Harne
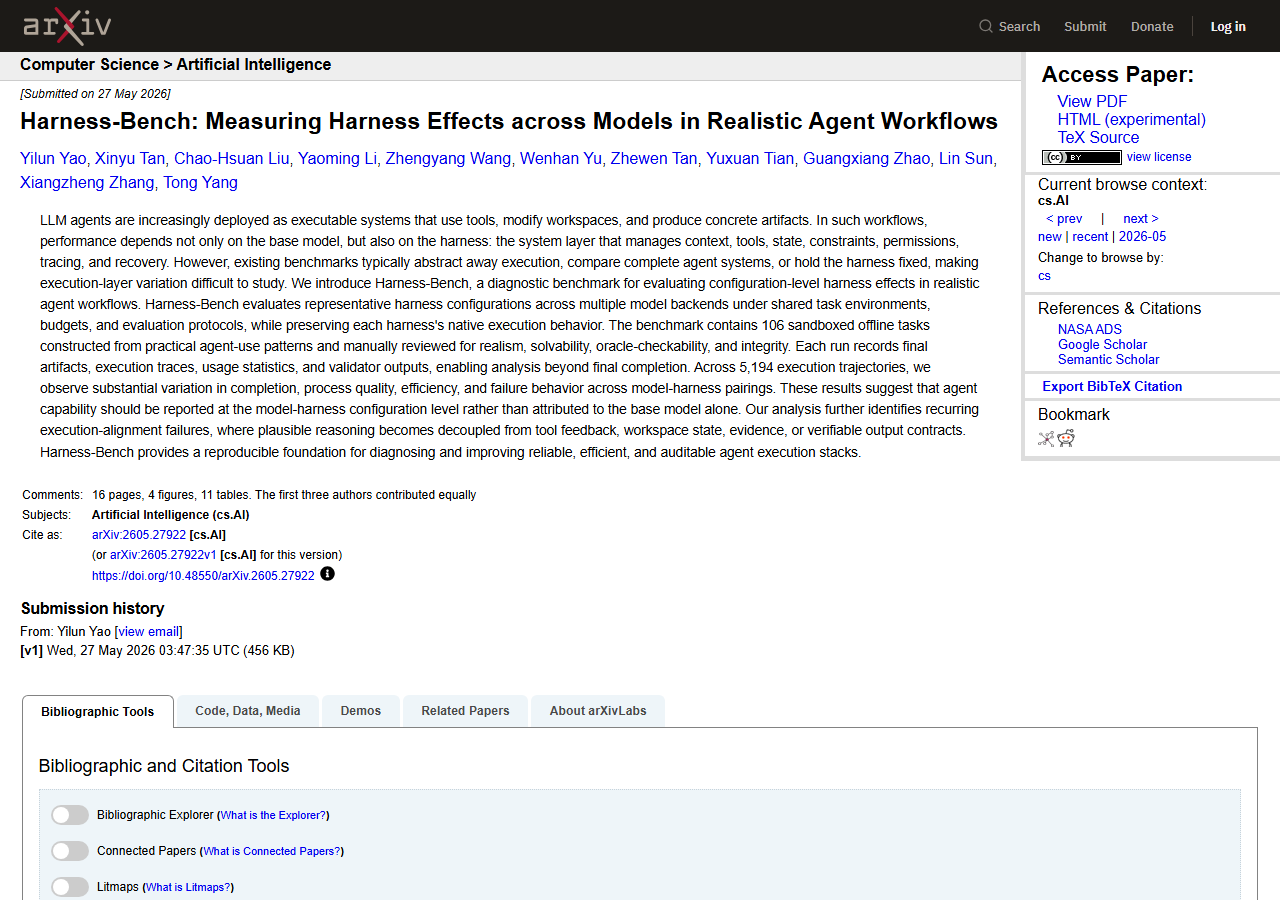
arXiv论文Harness基准
sierra-research/tau-bench
GitHub工具
Towards a Science of AI Agent
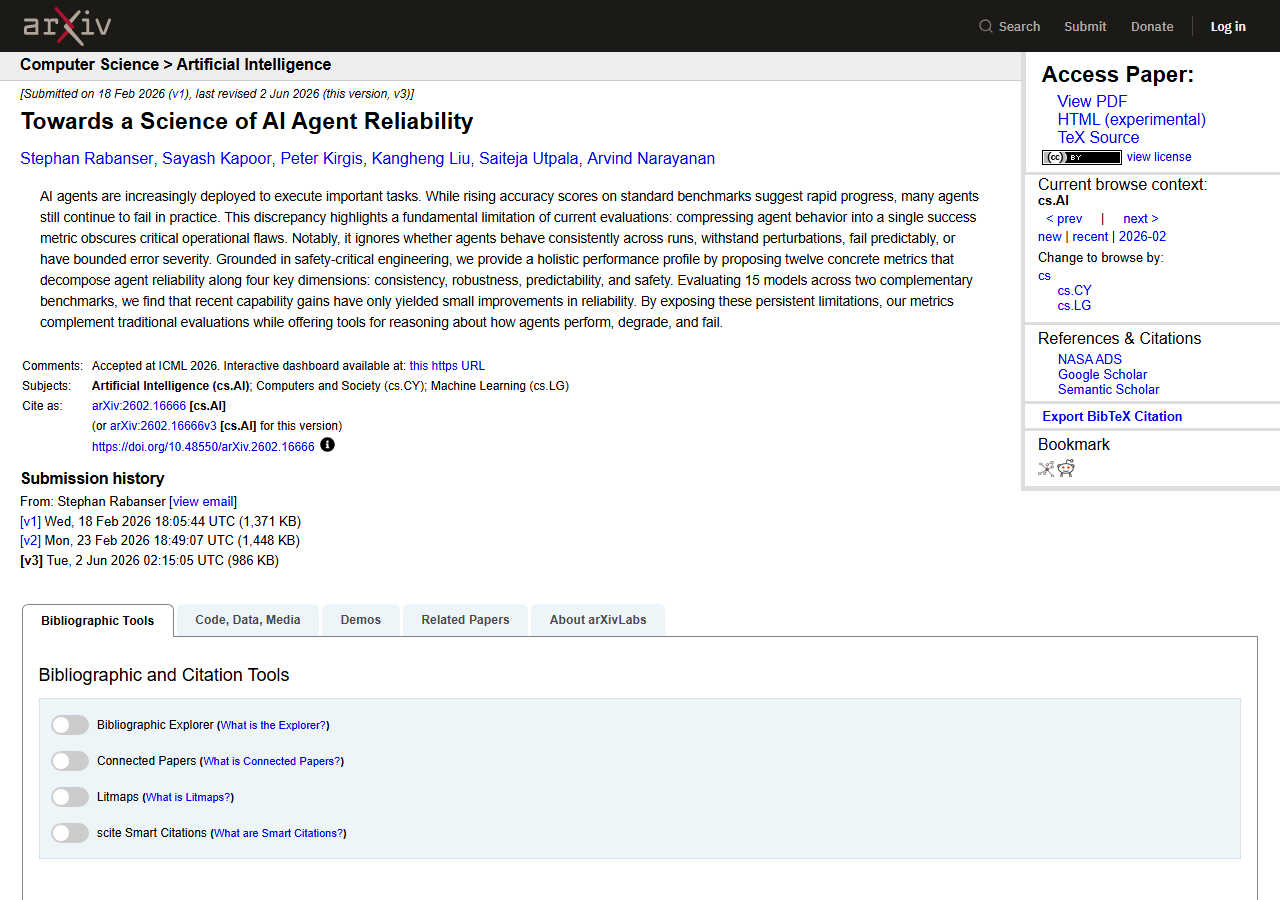
arXiv论文评估
Characterizing Faults in Agent
arXiv论文故障
VeRO: An Evaluation Harness fo
arXiv论文评估
Eval Awareness in Claude Opus
Anthropic评估
Designing AI-Resistant Technic
Anthropic技术
Amazon Bedrock AgentCore Evalu
AWS评估
Live-SWE-agent: First Live Sof
arXiv论文在线
OccuBench: Evaluating AI Agent
arXiv论文基准
microsoft/STATE-Bench
微软状态
评论

暂无评论,快来发表第一条评论吧